為什麼不能用 SEO 那套衡量
| 面向 | 傳統搜尋 | AI 搜尋 |
|---|---|---|
| 結果形式 | 排序清單 | 一段生成的答案 |
| 可重現性 | 高,同一題結果穩定 | 低,同一題可能不同 |
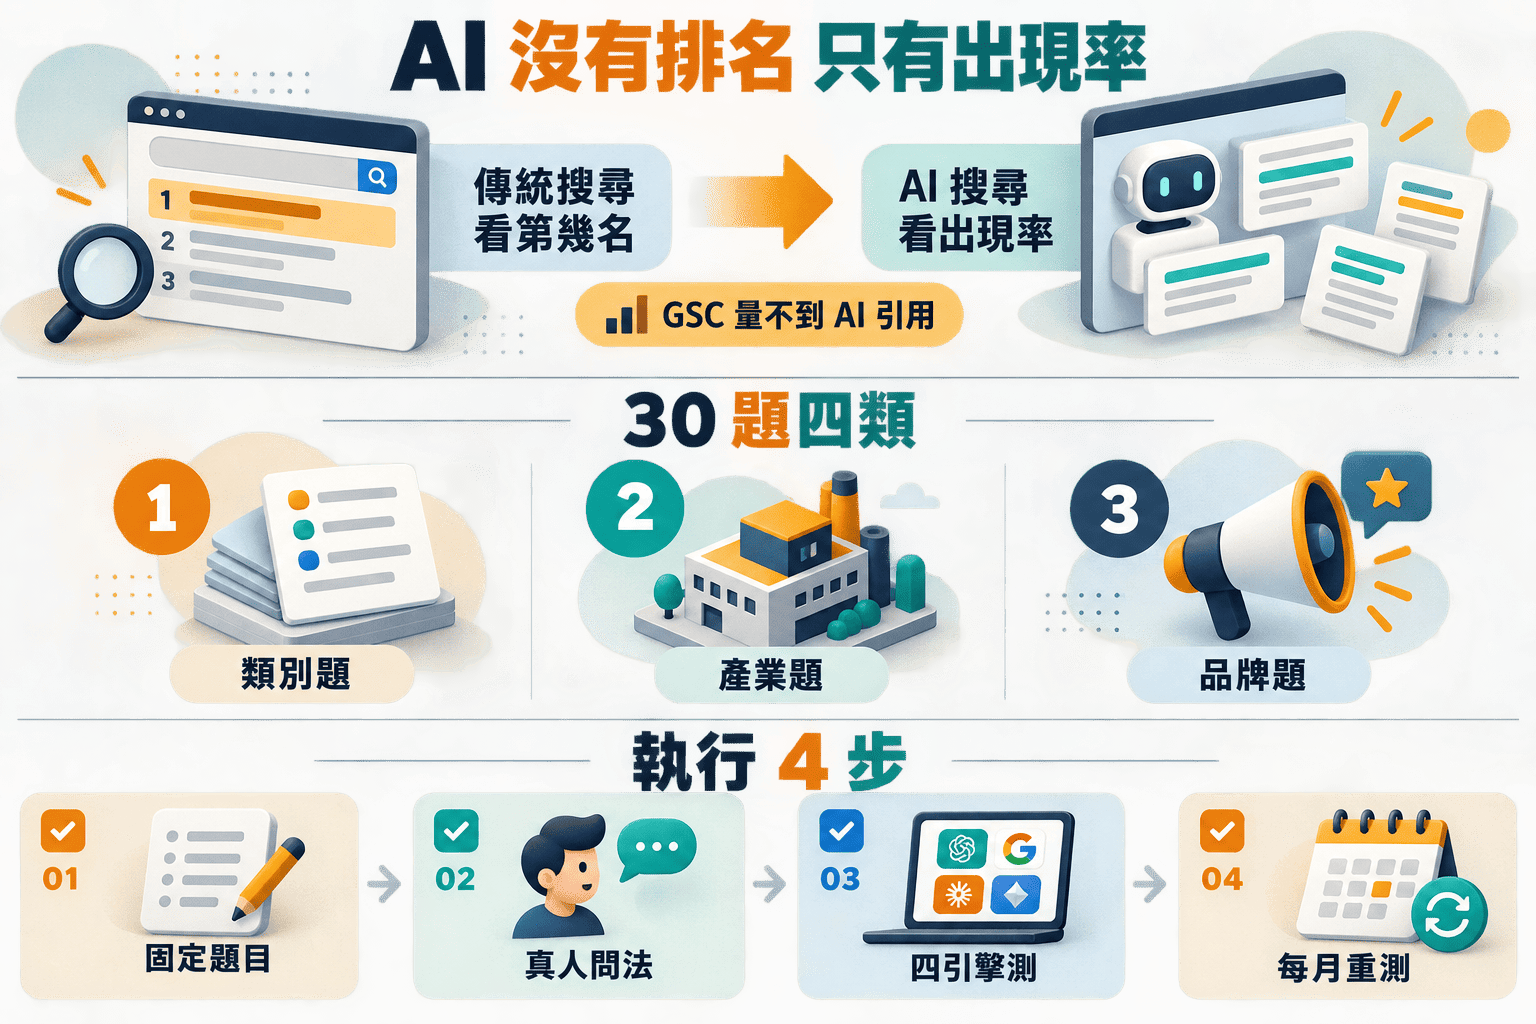
| 衡量單位 | 排名第幾 | 有沒有出現、出現幾次 |
| 官方數據 | GSC 有完整報表 | 沒有官方工具 |
| 影響因素 | 網頁本身的權重 | 跨來源的一致提及 |
最關鍵的差異:GSC 量不到 ChatGPT、Perplexity、Copilot 的引用,AI Overviews 的曝光也混在一般搜尋裡拆不出來。所以要自己建基準。
30 題基準法
題目怎麼設計
| 類型 | 題數 | 用途 | 範例 |
|---|---|---|---|
| 類別題 | 8 到 10 | 看有沒有進入推薦名單 | 台灣有哪些做 XX 的公司 |
| 產業應用題 | 6 到 8 | 看特定情境會不會想到你 | OO 產業要做 XX 可以找誰 |
| 能力題 | 6 到 8 | 看專業被不被認得 | 誰在做 XX 這件事 |
| 品牌題 | 4 到 6 | 防守,看被怎麼描述 | XX 是誰、XX 在做什麼 |
題目要用真人會問的口氣,不是關鍵字。「台灣有哪些 AI 實戰講師」比「AI 講師 台灣」更接近實際使用情境。
每題要記什麼
- 有沒有被點名:是或否,這是最基本的
- 被貼什麼標籤:AI 用什麼詞描述你,這比有沒有出現更重要
- 引用了哪些網址:知道 AI 從哪裡認識你,才知道該去哪裡經營
- 同時出現誰:競爭者名單,也是你該進入的名單
四個引擎的差異
| 引擎 | 特性 | 要注意 |
|---|---|---|
| ChatGPT 搜尋 | 引用來源明確,可點開 | 結果受帳號歷史影響,建議用無痕 |
| Perplexity | 引用最完整,適合看來源池 | 對新內容收錄較快 |
| Gemini | 與 Google 生態連動 | 可對照 AI Overviews 的結果 |
| Copilot | 偏向 Bing 索引 | Bingbot 的收錄狀況會直接反映 |
四個都要測的原因是來源池不同。有些品牌在 Perplexity 很常出現,在 ChatGPT 卻完全沒有,那代表被收錄的來源類型不同。
執行流程
- 固定題目:30 題寫成清單,之後不要隨意改(改了就失去對照性)
- 固定時間:每月同一天,避開剛發布內容的當週
- 用無痕視窗:避免帳號歷史影響結果
- 同一題只問一次:不要重問到滿意為止,那會造假
- 記進同一份表:欄位固定,才能看趨勢
【衡量 5 問】
- 你有基準線嗎?沒有的話無法判斷改善
- 題目夠貼近真人問法嗎?關鍵字式的題目測不出實際情況
- 你有記標籤嗎?被提到但描述錯誤是更該處理的問題
- 四個引擎都測了嗎?來源池不同,結果可能差很多
- 多久重測一次?建議每月同一天
【決策樹】測出來不理想怎麼辦
Q1:完全沒被提到?
├─ 連品牌題都沒有 → 基礎資料不足,先補官網與第三方檔案
└─ 類別題沒有但品牌題有 → 往下

Q2:品牌題有但標籤錯誤?
├─ 標籤是舊定位 → 去更新所有第三方平台的描述
└─ 標籤正確 → 往下

Q3:引用的來源是哪些?
├─ 多為第三方名單文 → 想辦法進入更多這類名單
├─ 只有自己官網 → 要增加外部提及
└─ 完全沒有引用你 → 內容的可摘錄性不足,改寫結構
【常見 3 錯誤】
- 錯誤 1:題目太少。五題十題的樣本波動太大,一次沒出現不代表退步
- 錯誤 2:每次問法不同。改了題目就失去對照性,趨勢就看不出來
- 錯誤 3:只記有沒有出現。被提到卻被貼錯標籤,比沒被提到更需要立刻處理
【檢核】建基準時打勾表
- ☐ 30 題已固定成清單且分四類
- ☐ 題目是真人問法不是關鍵字
- ☐ 記錄欄位含點名、標籤、引用來源、同時出現者
- ☐ 四個引擎都有測
- ☐ 已排定每月重測的固定日期
結論:先有基準,才談得上優化
AI 能見度最常見的狀況是「感覺好像有變好」但說不出依據。因為 GSC 量不到 AI 引用,不自己建基準就真的沒有數字可看。30 題、四個引擎、每月同一天,這套流程第一次做大概兩小時,之後每月一小時。花這個時間的價值在於:三個月後你能明確回答「被點名率從幾成變成幾成、標籤有沒有換掉」,而不是憑感覺。